Wer Software mit KI-Agenten baut, hat bald mehr Agenten als Überblick. Dieser Beitrag zeigt, wie wir das organisieren: Abteilungen mit eigenem Backlog, Aufträge als Dateien, GitHub als gemeinsame Ablage und eine Stelle, an der ein Mensch entscheidet. Das Modell funktioniert mit beliebig vielen Agenten aus beliebig vielen Konten. Wir setzen es seit Oktober 2026 für die Akademie ein. Danach kannst du den Ablauf erklären und entscheiden, was du für dein Team übernimmst.
Aufbau: wie eine Firma
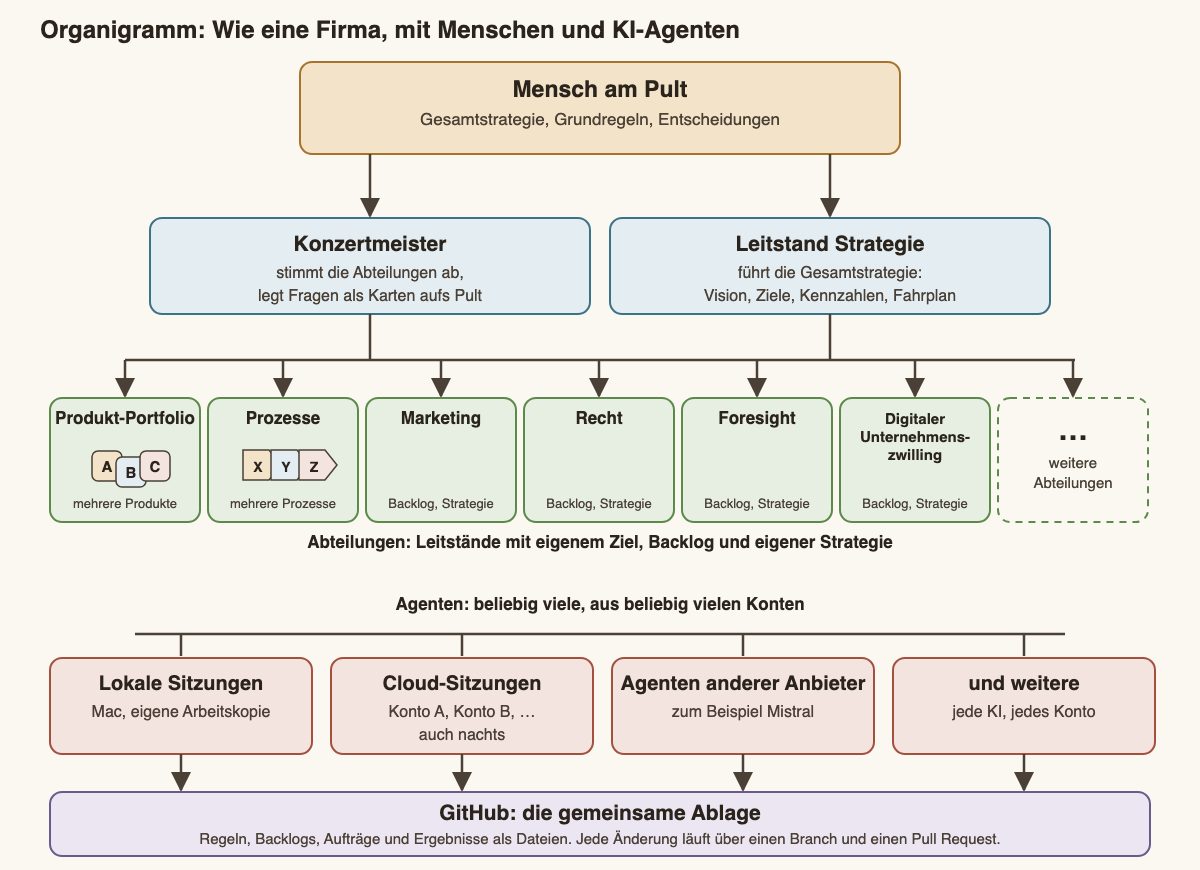
Das Modell ist ein Organigramm.
Oben entscheidet ein Mensch: Gesamtstrategie, Grundregeln, alle Freigaben. Bei uns heißt diese Stelle das Pult. Dort legt der Konzertmeister, ein KI-Chat, jede Frage als Karte vor. Daneben führt der Leitstand Strategie die Gesamtstrategie.
Darunter liegen die Abteilungen: Produkt-Portfolio, Prozesse, Marketing, Recht, Foresight, ein digitaler Unternehmenszwilling und was sonst gebraucht wird. Bei uns heißt jede Abteilung Leitstand und ist ein KI-Chat für einen Bereich. Sie hat ein Ziel, eine Messgröße, einen nächsten Meilenstein, ein Backlog (die Liste aller offenen Aufgaben) und eine eigene Strategie. Sie schneidet den Bedarf in Pakete, vergibt sie, prüft die Ergebnisse und legt sie vor.
Unten arbeiten die Agenten: Claude-Sitzungen auf dem eigenen Rechner, Claude-Sitzungen in der Cloud und Agenten anderer Anbieter. Seit Ende Oktober 2026 arbeiten auch Agenten von Mistral zu. Ihre Zahl ist offen.
So laufen die Agenten technisch
Die Agenten sprechen nicht miteinander. Sie arbeiten über ein gemeinsames Repository, das ist die Schnittstelle.
- Claude: Wir nutzen die Claude Desktop App mit Claude Code. Lokale Sitzungen laufen auf dem Mac, jede in einer eigenen Arbeitskopie. Cloud-Sitzungen laufen nachts als Routine bei Anthropic und arbeiten die Aufträge der Reihe nach ab.
- Mistral: Die Agenten laufen im Mistral Studio, zum Teil auch in Vibe. Sie bekommen einen GitHub-Anschluss (Connector), arbeiten auf einem eigenen Branch und dürfen nur bestimmte Dateien schreiben.
- MCP: Dazu gibt es einen eigenen MCP-Server. Er gibt einer KI Werkzeuge für den Stand der Automatisierung, das Wissensregister, die Search Console, Google Drive und Notion. Er ist nur lesend, das einzige Schreibwerkzeug ist standardmäßig aus. Welche Werkzeuge eine KI sieht, hängt von ihrer Datenklasse ab (Regel 6). Aufträge und Ergebnisse laufen aber nicht über MCP, sondern über Dateien und Pull Requests.
Gesamtstrategie und OKR
Abteilungen ohne gemeinsame Richtung driften auseinander. Darum gibt es eine Gesamtstrategie an einem Ort: Vision, Ziele für lange, mittlere und kurze Sicht und einen Fahrplan. Die Ziele sind als OKR formuliert (Objectives and Key Results). Dazu gilt eine Regel: Ein Key Result zählt nur, wenn eine Abfrage die Zahl liefert. Was nicht ablesbar ist, ist eine Absicht. Stand 25.10.2026: 4 von 12 Key Results sind schon aus Daten messbar, der Rest ist offene Arbeit.
Die Abteilungen schlagen ihre OKR für ihr Selbstmanagement selbst vor, der Mensch entscheidet. Jedes Ziel einer Abteilung dient einem Ziel der Gesamtstrategie oder hat ein eigenes Budget und ein Datum.
Darunter stehen die Grundregeln, eine einzige Seite, die jede andere Regeldatei schlägt. Sie sagen zum Beispiel: Der Engpass ist der Mensch, der entscheidet. Agenten bauen schneller, als sich prüfen lässt, also richtet sich alles nach der Prüfzeit. Ein Ja des Menschen brauchen nur vier Dinge: Mails an Kunden oder Dritte, Geld, kritische Seiten und das Löschen kritischer Daten. Alles andere entscheiden die Abteilungen selbst, umkehrbar und mit Sicherung vorher.
Acht Regeln für beliebig viele Agenten
Damit zehn Agenten aus fünf Konten nicht durcheinanderlaufen, gelten für alle dieselben Regeln. Sie stehen als Dateien im Repository, weil nur Dateien jede KI lesen kann, egal von welchem Anbieter, und weil ein Chat vergisst.
- Der Auftrag ist eine Datei. Ziel, Ort, „Fertig, wenn …“ und Grenzen stehen darin, dazu der Status „startklar“. Ein Agent liest die Datei und braucht keine Nachricht.
- Anspruch anmelden. Wer einen Auftrag nimmt, pusht als Erstes einen leeren Commit „in Arbeit“ auf einen eigenen Branch, ohne Force. Wird der Push abgelehnt, war jemand schneller, und der Agent nimmt den nächsten Auftrag. Danach prüft er noch einmal, wer zuerst war.
- Ein eigener Branch je Agent. Niemand schreibt direkt nach
main, niemand teilt sich einen Ordner. Gemerged wird nur von der Abteilung, nach der Prüfung. - Rückmeldung als Datei. Cloud-Sitzungen und fremde Agenten melden sich nicht zurück, und Nachrichten erreichen ein anderes Konto nicht. Darum endet jeder Auftrag mit einer Sichtungsseite (was ist anders, wie prüft man es, was ist offen) und einem Draft Pull Request.
- Gegenprüfung. Ein Agent prüft nie seine eigene Arbeit. Bei sehr schnellen Agenten kontrolliert die Abteilung Stichproben und übernimmt Ergebnisse als maschinenlesbare Ersetzungen: Quelle, alter Text genau einmal, neuer Text.
- Datenklassen. Jede Information hat eine Klasse (öffentlich, intern, personenbezogen, geheim), und jedes Werkzeug hat eine Freigabe. Sie hängt davon ab, ob der Anbieter in diesem Tarif mit den Daten trainiert. Geheimes sieht keine KI, Werte holen nur Skripte. Agenten in der Cloud bekommen keine Zugänge oder Schlüssel. Was Zugänge braucht, baut die Abteilung am eigenen Rechner nach einem Trockenlauf.
- Bremse und Budget. Liegen acht fertige Branches ungesichtet da, holt sich niemand Neues. Jedes Konto hat ein Kontingent, und das ist ein Budget, kein Takt.
- Ein neues Konto bekommt einen Übergabe-Text. Er sagt dem neuen Agenten, wo die Aufträge liegen, was er darf und was nicht. Dann fängt er an.
So sah das bei den ersten Mistral-Agenten aus: Zwei nahmen in derselben Minute dieselbe Aufgabe, und ihre Ergebnisse kamen in ein bis zwei Minuten je Aufgabe, schnell, aber oberflächlich. Aus dem ersten Fall wurde Regel 2 mit dem Nachsehen, aus dem zweiten die Gegenprüfung in Regel 5.
GitHub in fünf Minuten
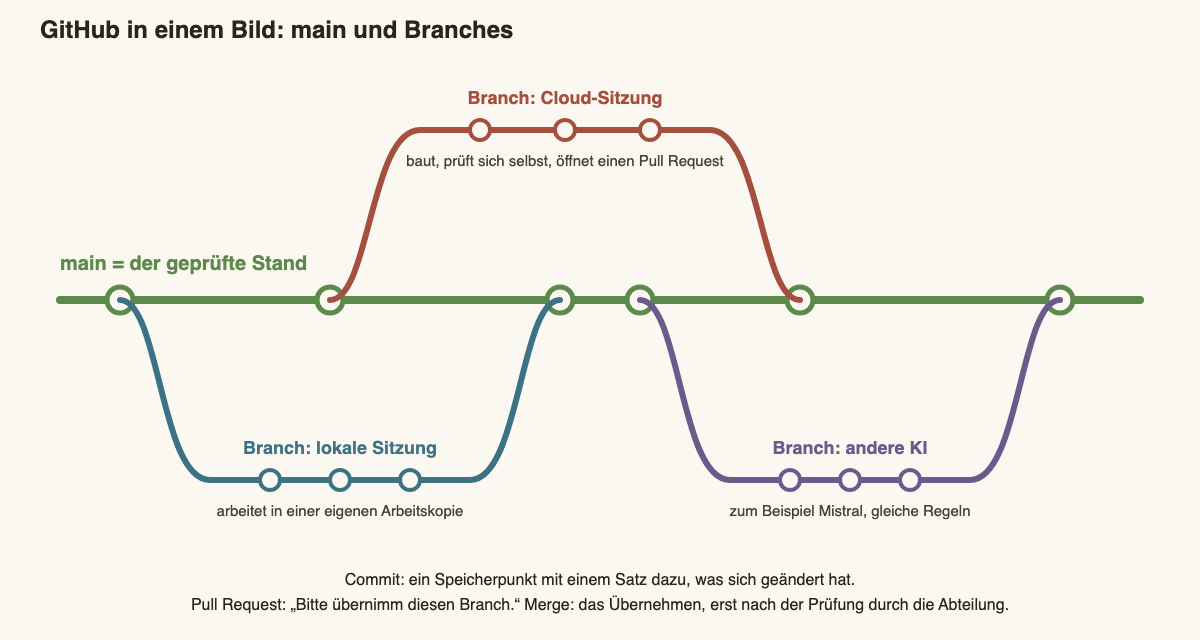
Stell dir ein Manuskript vor, an dem viele Menschen arbeiten. Es gibt eine Originalfassung. Wer etwas ändern will, kopiert sie, arbeitet in der Kopie und legt sie dem Lektorat vor. Das Lektorat liest nur die Änderungen, erst danach wird die Originalfassung angepasst. Alte Fassungen bleiben erhalten. Genau das macht GitHub, nur für ganze Ordner voller Dateien.
- Repository (Repo): der Ordner mit seinem ganzen Gedächtnis: jede Datei, jede Fassung, wer was wann geändert hat.
main: die Originalfassung, der geprüfte Stand. Nur von hier geht etwas live.- Branch: eine eigene Arbeitskopie. Mehrere Branches gleichzeitig stören sich nicht.
- Commit: ein Speicherpunkt mit einem Satz dazu, was sich geändert hat. Man kann jederzeit dorthin zurück.
- Pull Request (PR): die Bitte „Bitte übernimm meine Änderungen nach
main.“ Der Prüfer sieht genau, was sich ändert: Gelöschtes rot, Neues grün. Ein Draft ist ein PR, der noch nicht übernommen werden soll. - Merge: Die Änderungen fließen nach
main. - Actions: automatische Tests, die bei jeder Änderung laufen.
Für KI-Agenten passt das gut: Jede Änderung hat Absender, Zeitpunkt und Begründung. Mehrere Agenten arbeiten parallel, ohne einander zu überschreiben. Nichts geht verloren, jede Änderung lässt sich zurücknehmen. Und der Mensch prüft nur den Unterschied, nicht das Ganze.
Der Weg einer Änderung

- Der Mensch nennt einen Bedarf, zum Beispiel: Vier Artikel sollen einen neuen Abschnitt bekommen.
- Die Abteilung schreibt den Auftrag. Sie schneidet den Bedarf in Pakete und legt je Paket eine Datei an: Ziel, Ort, „Fertig, wenn …“, Grenzen, Status „startklar“.
- Der Auftrag kommt nach
main. Agenten sehen nur, was dort liegt. - Ein Agent holt ihn sich. Er meldet sich mit dem leeren Commit an und baut auf seinem Branch. Cloud-Sitzungen laufen nachts, andere tagsüber.
- Er meldet sich per Datei zurück. Am Ende stehen eine Sichtungsseite und ein Draft Pull Request.
- Die Abteilung sichtet. Sie liest den Unterschied, lässt Tests laufen und mergt das Gute nach
main. Live geht nur ein Skript mit Trockenlauf, Sicherung vorher und Rückweg, gestartet von einem sauberenmain. - Der Mensch sieht eine Karte am Pult, mit dem Ergebnis im Wortlaut. Was sein Ja braucht, geschieht erst danach. Alles andere ist schon erledigt und steht als „Zur Kenntnis“ da.
Der Mensch nimmt sich dafür zwei feste Fenster pro Woche. Dazwischen arbeiten die Abteilungen weiter.
Fünf Stolpersteine
Alle aus dem Oktober 2026, jeder mit der Regel, die daraus wurde.
Ein Ordner für alle (1. Oktober). Zwei Sitzungen arbeiteten im selben Ordner. Die eine schaltete auf ihren Branch um, der anderen fehlten ihre Dateien. Ein Ausrollen von dort hätte fünf Commits auf dem Server zurückgedreht. Seitdem hat jede Sitzung ihre eigene Arbeitskopie, und der gemeinsame Ordner bleibt auf main.
Der Chat, der verschwand (23. Oktober). Ein Leitstand-Chat war an einen Pull Request gebunden. Als der PR schloss, archivierte die App den Chat. Jetzt binden Leitstand-Chats keinen PR. Cloud-Sitzungen öffnen ihn absichtlich als Draft, damit sie nach dem Merge von selbst archiviert werden.
Die Antwort, die niemand hörte (24. Oktober). Antworten am Pult weckten den Chat nicht immer, eine lag eine Stunde unbemerkt. Jetzt liest der Chat zu Beginn jedes Zugs alle Antworten nach, auch ohne Weckruf.
Dieselbe Aufgabe, zweimal (Ende Oktober). Zwei Agenten nahmen in derselben Minute dieselbe Aufgabe. Seitdem sieht jeder Agent nach dem Anmelden noch einmal nach, wer zuerst war.
Das leere Budget (27. Oktober). Die Actions liefen bei jedem Push, rund 210 Läufe und 350 Minuten am Tag, bis das GitHub-Budget aufgebraucht war. Jetzt laufen die Tests einmal pro Nacht, und wenn etwas eilt, startet die Abteilung sie von Hand.
Wie weit das reicht: die Treppe
Ist das schon das Ende dessen, was mit KI geht? Nein. Wer Prozesse entwickelt, steigt eine Treppe hinauf: vom Wildwuchs, in dem das Wissen in einzelnen Köpfen steckt, über Definieren, Analysieren und Optimieren bis zum Automatisieren. Das Modell in diesem Beitrag steht auf der vierten Stufe: Agenten erledigen die Arbeit, der Mensch entscheidet. Darüber liegen drei weitere Stufen.

- Stufe 5, Prüfen automatisieren: Heute liest der Mensch jeden Unterschied selbst, und das ist der Engpass. Auf dieser Stufe hat jeder Auftrag ein „Fertig, wenn …“, das eine Maschine prüfen kann, und ein zweites Modell prüft über Kreuz. Zum Menschen kommt nur, was abweicht. Wie nötig das ist, haben wir nachgezählt: Von 81 Textersetzungen, die Agenten vorgeschlagen hatten, waren nur 26 sicher. Die übrigen änderten den Inhalt, erfanden Fakten oder trafen veraltete Kopien.
- Stufe 6, Agenten im Betrieb: Agenten bauen nicht mehr nur, sie führen Abläufe dauerhaft, etwa Anfragen, Buchungen oder Belege. Jeder hat ein Budget, feste Grenzen und einen Rückweg. Der Mensch sieht nur die Ausnahmen.
- Stufe 7, die lernende Organisation: Das System schlägt aus gemessenen Ergebnissen selbst neue Regeln vor, probiert sie an einem Teil der Arbeit aus und behält nur, was messbar hilft. Ein digitaler Unternehmenszwilling spielt Entscheidungen vorher durch.
Wir haben die fünfte Stufe begonnen: Die Gegenprüfung über Kreuz hat bei uns Vorrang vor neuer Arbeit.
Methode: Markov-Simulation für User Journeys und Features
Ein Stück der siebten Stufe geht schon heute: Nutzerverhalten durchspielen, bevor man baut. Wo steigen Menschen aus einer User Journey aus? Welches Feature hält sie, welches stört? Eine Markov-Kette beantwortet das als Rechnung. Sie besteht aus Zuständen und den Wahrscheinlichkeiten, von einem Zustand in den nächsten zu wechseln. Dabei zählt nur, wo jemand gerade steht, nicht wie er dorthin kam. Man kann sie sich als Wanderer ohne Gedächtnis vorstellen, der an jeder Kreuzung würfelt. Schickt man tausend davon los, sieht man, wo sie ankommen und wo sie hängen bleiben.

- Zustände festlegen. Die Stationen der Journey, etwa Besuch, Anmeldung, erster Schritt, aktiv, wiederkehrend, Ziel erreicht. Dazu der Endzustand „abgesprungen“.
- Übergänge messen. Die Wahrscheinlichkeiten kommen aus echten Daten: Analytics, Logs, Fortschritt. Ein Skript zählt nur Summen, die KI sieht keine Personen.
- Den Engpass finden. Die Kette rechnet aus, wie wahrscheinlich das Ziel von jedem Zustand aus ist und wo die meisten verloren gehen.
- Stellschrauben drehen. Jeder Übergang wird einzeln verbessert, etwa um zehn Prozentpunkte. Welcher bringt die meisten ans Ziel? Ein geplantes Feature ist hier eine Annahme: Es verschiebt einen oder mehrere Übergänge, und die Kette zeigt, was am Ende ankommt.
- Stimmen am Engpass holen. Die Zahl sagt, wo es hakt, nicht warum. Darum lesen synthetische Nutzer die echte Seite am Engpass, jede Persona in einem eigenen Aufruf eines Sprachmodells. Sie antworten: Was hält mich hier? Was lässt mich aussteigen? Was würde mir Freude machen? Das ist eine Vermutung, kein Befund.
- Die Entscheidung vorbereiten. Daraus werden wenige Vorschläge, jeder mit Engpass, Begründung und einer Messung, die später zeigt, ob er wirkt. Am Ende steht keine Prognose, sondern eine Frage an echte Testerinnen und Tester.
Wirken Nutzer aufeinander, etwa über Gruppen, Kommentare oder Empfehlungen, reicht eine Kette nicht. Dann rechnet Code viele synthetische Nutzer über Wochen, mit festem Zufallsstart und vielen Läufen. Ohne das neue Feature muss dieses Modell die gemessene Kette treffen.
Erst so lassen sich Fragen wie diese beantworten:
- Wann entstehen zwischen den Nutzern neue Zustände und Dynamiken, etwa Gruppen oder Nutzer, die andere mitziehen?
- Wo liegen Kipppunkte, etwa die kritische Masse, ab der sich eine Gemeinschaft selbst trägt?
- Welche Features haben welche Wirkung, auch auf die anderen Nutzer?
Nahe einem Kipppunkt entscheidet der Zufall mit. Darum zeigt man, in wie vielen Läufen es kippt.
Neu ist die Markov-Kette dafür nicht: In der Marketing-Forschung beschreibt sie seit Jahren, wie Menschen durch eine Customer Journey gehen.[1] Neu ist, Sprachmodelle als synthetische Nutzer dazuzunehmen. Das ist umstritten, darum liefern sie hier nur Vermutungen und keine Zahlen.
Wie gut solche Vermutungen sind, hängt an drei Dingen:
- Echte Daten je Person. Agenten, gebaut aus je einem zweistündigen Interview, trafen die Antworten ihrer Vorbilder in einer großen Umfrage zu 85 Prozent so gut, wie diese Menschen sich selbst zwei Wochen später trafen. Mit Alter, Geschlecht und Herkunft allein waren es 74 Prozent.[2]
- Das Modell. Das Training auf Hilfsbereitschaft macht Modelle einiger und freundlicher als Menschen. Manche Gruppen, etwa Menschen über 65, bilden sie kaum ab.[3]
- Der Abgleich. In einem Shop handelten KI-Agenten zielstrebiger als echte Kunden. Sichtbar wurde das erst im Vergleich.[4]
Für die Methode heißt das: Personas aus echten Aussagen bauen, nicht aus Merkmalen, und am Ende mit echten Menschen abgleichen.
Ein Beispiel: Auf unserer Lernplattform zeigte die Kette den größten Abfluss früh, im ersten Viertel eines Kurses. Dort liegt das erste Arbeitsblatt. Die synthetischen Nutzer stockten vor seinen leeren Feldern, weil unklar war, was hineingehört. Als Nächstes testen wir deshalb ein fertig ausgefülltes Muster direkt neben dem Blatt. Ob dann mehr Menschen weitergehen, zeigt erst die Messung mit echten Nutzern.
Drei Arten von Unsicherheit. Wer die Ergebnisse liest, muss sie auseinanderhalten:
- Zufall: Jeder Lauf würfelt anders. Das gehört zur Methode und wird mit mehr Läufen kleiner: Viermal so viele Läufe halbieren die Streuung. Darum zeigt man die Spanne.
- Annahmen: Was nicht gemessen ist, wird gesetzt. Mehr Läufe machen ein Ergebnis genauer, nicht richtiger. Ein Modell von uns ergab „Der Newsfeed trägt sich nicht von allein“, weil darin niemand teilte. Ein zweites ließ 30 Prozent teilen und kam zum Gegenteil. Darum wird jede Annahme selbst zur Stellschraube.
- Fehler: Wochen als Tage gelesen, ein Baustein, der gar nicht angeschlossen war. Dagegen helfen ein Test mit bekannter Antwort und ein zweiter Agent, der nachrechnet.
Daraus folgt die wichtigste Regel: Die Simulation zeigt, welche Stellschrauben zählen, nicht wie es wirklich kommt. Der Statistiker George Box sagte es so: Alle Modelle sind falsch, aber manche sind nützlich.[5] Jede Zahl jenseits der gemessenen Grundlage ist Modell. Und eine Markov-Kette hat kein Gedächtnis: Wer zum zweiten Mal pausiert, verhält sich vielleicht anders. Wo das zählt, bekommt es einen eigenen Zustand.
Bekannte Prinzipien, bekannte Denkfehler
Das meiste in diesem Modell ist nicht neu. Fast jede Regel hat in SCRUM oder im Design Thinking schon einen Namen. Und fast jeder Stolperstein ist ein bekannter Denkfehler. Wer die Namen kennt, findet schneller, was dagegen hilft, denn andere haben es längst ausprobiert.
Das beginnt beim Aufbau. Nach dem Gesetz von Conway spiegelt ein System die Kommunikation der Organisation, die es baut.[6] Wer Agenten ordnet, prägt damit auch die Software. Darum steht am Anfang dieses Modells ein Organigramm.
| Bei uns | Bekannter Name |
|---|---|
| Der Mensch am Pult setzt die Ziele und gibt frei, was live geht | Stakeholder (SCRUM), bei uns der Inhaber |
| Der Konzertmeister wählt nach diesen Zielen aus dem Backlog (im Test seit Ende Oktober 2026) | Product Owner (SCRUM) |
| Der Konzertmeister stimmt die Abteilungen ab | Scrum of Scrums, die Abstimmung vieler Teams (SCRUM) |
| Ein eigener Agent prüft den Weg, bevor etwas in die Breite geht (im Test seit Ende Oktober 2026) | Scrum Master (SCRUM) |
| Der Auftrag nennt „Fertig, wenn …“ | Definition of Done (SCRUM) |
| Der Status „startklar“ | Definition of Ready (SCRUM) |
| Zwei feste Fenster pro Woche zum Sichten | Sprint Review (SCRUM) |
| Aus jedem Stolperstein wird eine Regel | Retrospektive (SCRUM), Kaizen |
| Alles richtet sich nach der Prüfzeit | Engpasstheorie (Theory of Constraints) |
| Bremse bei acht ungesichteten Branches | WIP-Limit, eine Obergrenze für angefangene Arbeit (Kanban) |
| Ein Agent prüft nie seine eigene Arbeit | Vier-Augen-Prinzip, Code Review |
| Jede KI sieht nur ihre Datenklasse | Prinzip der geringsten Rechte (IT-Sicherheit) |
| Eine Seite Grundregeln schlägt jede andere Regel | Single Source of Truth, eine einzige Quelle je Regel |
| Die Zahl zeigt den Engpass, synthetische Nutzer vermuten den Grund | Problemraum vor Lösungsraum, Persona (Design Thinking) |
| Ein Feature ist eine Annahme, die Messung entscheidet | Build, Measure, Learn (Lean Start-Up) |
Diese fünf Denkfehler zeigen sich bei Agenten besonders deutlich:
- Mehr Hände, mehr Arbeit. Nach dem Gesetz von Brooks macht zusätzliches Personal ein verspätetes Softwareprojekt noch später, weil Einarbeitung und Abstimmung wachsen.[7] Agenten brauchen kaum Einarbeitung. Aber jedes Ergebnis muss gesichtet werden, und zehn Agenten liefern zehnmal so viel. Dagegen hilft die Bremse aus Regel 7.
- Der Maschine glauben. Menschen übernehmen Vorschläge einer Maschine zu leicht, besonders wenn sie viele Aufgaben zugleich haben. Die Forschung nennt das Automation Bias.[8] Von unseren 81 Textersetzungen waren nur 26 sicher. Darum liest der Mensch den Unterschied selbst, und am Pult steht das Ergebnis im Wortlaut, nicht als Zusammenfassung.
- Das Eigene bestätigen. Wer prüft, sucht eher, was die eigene Annahme stützt. Das ist der Bestätigungsfehler. Sprachmodelle haben eine eigene Form davon: Als Prüfer bewerten sie eigene Texte besser als fremde, die Menschen für gleich gut halten.[9] Dazu stimmen sie gern zu, auch wenn der Mensch irrt.[10] Darum prüft immer ein zweiter Agent (Regel 5).
- Am Fertigen festhalten. Was schon viel gekostet hat, gibt man ungern auf, auch wenn es nicht trägt. Das sind die versunkenen Kosten.[11] Agenten liefern in Minuten Ergebnisse, die fertig aussehen. Rollt man sie gleich auf viele Seiten aus, kostet das Zurückbauen viel Arbeit. Darum gilt die Haltung aus dem Design Thinking: Ein Prototyp ist grob und darf weg. Ausgebaut wird erst, was an einer Stelle besteht.
- Dem Netz vertrauen. Wer verteilte Software baut, nimmt gern an, das Netz sei zuverlässig. Das ist der erste der bekannten Irrtümer verteilter Systeme.[12] Bei Agenten heißt das: Eine Nachricht kommt nicht an, ein Chat wacht nicht auf, ein anderes Konto hört nichts. So war es am 24. Oktober. Darum laufen Aufträge und Rückmeldungen als Dateien (Regel 1 und 4).
Was du übernehmen kannst
Du brauchst dafür weder Mistral noch Claude noch ein großes Team. Fünf Dinge reichen für den Anfang: eine Seite Grundregeln und eine Stelle für Entscheidungen. Pro Bereich eine Liste und ein Ziel. Aufträge als Dateien statt als Nachrichten. Für jeden Agenten einen eigenen Branch, und main nur nach Prüfung. Und eine Regel, welche KI was sehen darf. Alles Weitere wächst mit: Mit jedem neuen Agenten bekommt die Abteilung mehr Arbeitskraft, der Mensch entscheidet wie vorher an einer Stelle.
Wie wir mit KI Online-Kurse entwickeln, beschreiben wir in Online-Kurse mit KI entwickeln. Welche Stufen von KI-Modellen es gibt und wie sich Prozesse mit KI-Agenten automatisieren lassen, steht in Prozess-Automatisierung mit KI.
Quellen
[1] Anderl, E., Becker, I., von Wangenheim, F., Schumann, J. H. (2016): Mapping the customer journey: Lessons learned from graph-based online attribution modeling. International Journal of Research in Marketing 33(3), 457–474. doi.org/10.1016/j.ijresmar.2016.03.001
[2] Park, J. S. u. a. (2024): Generative Agent Simulations of 1,000 People. arXiv 2411.10109, erste Fassung. arxiv.org/abs/2411.10109v1
[3] Santurkar, S. u. a. (2023): Whose Opinions Do Language Models Reflect? ICML 2023, PMLR 202, 29971–30004. proceedings.mlr.press/v202/santurkar23a.html
[4] Lu, Y. u. a. (2025): AgentA/B: Automated and Scalable Web A/B Testing with Interactive LLM Agents. arXiv 2504.09723. arxiv.org/abs/2504.09723
[5] Box, G. E. P. (1979): Robustness in the Strategy of Scientific Model Building. In: Launer, R. L., Wilkinson, G. N. (Hg.): Robustness in Statistics. Academic Press, 201–236. doi.org/10.1016/B978-0-12-438150-6.50018-2
[6] Conway, M. E. (1968): How Do Committees Invent? Datamation 14(4), 28–31. melconway.com/Home/Committees_Paper.html
[7] Brooks, F. P. (1975): The Mythical Man-Month. Essays on Software Engineering. Addison-Wesley, Kapitel 2. Jubiläumsausgabe 1995: informit.com
[8] Parasuraman, R., Manzey, D. H. (2010): Complacency and Bias in Human Use of Automation: An Attentional Integration. Human Factors 52(3), 381–410, DOI 10.1177/0018720810376055. pubmed.ncbi.nlm.nih.gov/21077562
[9] Panickssery, A., Bowman, S. R., Feng, S. (2024): LLM Evaluators Recognize and Favor Their Own Generations. arXiv 2404.13076, NeurIPS 2024. arxiv.org/abs/2404.13076
[10] Sharma, M. u. a. (2023): Towards Understanding Sycophancy in Language Models. arXiv 2310.13548, ICLR 2024. arxiv.org/abs/2310.13548
[11] Arkes, H. R., Blumer, C. (1985): The Psychology of Sunk Cost. Organizational Behavior and Human Decision Processes 35(1), 124–140. doi.org/10.1016/0749-5978(85)90049-4
[12] van Steen, M., Tanenbaum, A. S. (2023): Distributed Systems. 4. Auflage, Kapitel 1, Abschnitt „Pitfalls“ mit den falschen Annahmen nach Peter Deutsch. distributed-systems.net